PostgreSQL Enterprise Disaster Recovery
PostgreSQL Enterprise Disaster Recovery é a abordagem estruturada para proteger bancos de dados PostgreSQL corporativos contra falhas de infraestrutura, corrupção de dados, indisponibilidade de servidores, perda de um site ou data center, erros operacionais e outros eventos capazes de interromper serviços críticos. Em ambientes empresariais, disaster recovery não deve ser tratado apenas como a existência de backups: é necessário combinar replicação, recuperação, cópias consistentes, armazenamento externo, procedimentos de failover, recuperação de ambientes e testes periódicos.
Em arquiteturas PostgreSQL Enterprise, o objetivo do disaster recovery é reduzir o impacto de incidentes sobre aplicações e dados, estabelecendo mecanismos capazes de recuperar o ambiente dentro de parâmetros previamente definidos de RPO e RTO. Isso exige uma arquitetura planejada para o cenário de falha, e não apenas uma infraestrutura preparada para operar normalmente.
O que é PostgreSQL Enterprise Disaster Recovery
PostgreSQL Enterprise Disaster Recovery é o conjunto de tecnologias, processos, arquiteturas e procedimentos utilizados para recuperar um ambiente PostgreSQL corporativo após um evento que comprometa sua operação normal.
O conceito envolve mais do que alta disponibilidade. Alta disponibilidade normalmente busca manter o serviço operacional diante de falhas previstas na infraestrutura primária. Disaster recovery, por outro lado, precisa considerar cenários mais amplos, incluindo a perda completa de um servidor, cluster, storage, ambiente de virtualização, região ou até mesmo um site inteiro.
Uma estratégia empresarial de recuperação pode envolver:
- Replicação física entre servidores PostgreSQL.
- Servidores standby.
- Streaming replication.
- WAL archiving.
- Backup completo e incremental.
- Point-in-Time Recovery.
- Armazenamento de backups fora do servidor principal.
- Ambientes secundários para disaster recovery.
- Automação de failover.
- Procedimentos de reconstrução do ambiente.
- Monitoramento da infraestrutura.
- Testes periódicos de recuperação.
- Documentação operacional.
O PostgreSQL fornece os mecanismos fundamentais para implementar replicação, recuperação e failover, mas uma arquitetura corporativa precisa combinar esses recursos com ferramentas e processos adicionais para atingir os objetivos de continuidade definidos para cada aplicação.
Disaster Recovery não é apenas backup
Um dos erros mais comuns em projetos PostgreSQL Enterprise é considerar que a existência de backups representa, por si só, uma estratégia de disaster recovery.
O backup é um dos componentes do plano, mas não resolve sozinho questões como:
- Quanto tempo será necessário para recuperar o banco?
- Onde o backup está armazenado?
- O backup está protegido contra a perda do ambiente principal?
- Os arquivos podem ser restaurados?
- Qual ponto no tempo deve ser recuperado?
- Como a aplicação será reconectada ao ambiente recuperado?
- Quem executará o procedimento?
- Como será validada a consistência dos dados?
- Como o ambiente será reconstruído após a recuperação?
- Quando o ambiente secundário deverá assumir a produção?
Uma política empresarial de disaster recovery deve responder a essas perguntas antes que um incidente ocorra.
RPO e RTO no PostgreSQL Enterprise
O que é RPO
RPO — Recovery Point Objective representa a quantidade máxima de dados que a organização aceita perder em um incidente.
Por exemplo, se uma aplicação possui RPO de cinco minutos, a arquitetura precisa ser capaz de recuperar os dados até um ponto suficientemente próximo do momento do incidente para que a perda potencial permaneça dentro desse limite.
O RPO influencia diretamente a arquitetura de replicação, frequência de backups, retenção de WAL e estratégia de recuperação.
O que é RTO
RTO — Recovery Time Objective representa o tempo máximo aceitável para restaurar determinado serviço após uma interrupção.
Um ambiente com RTO de várias horas pode utilizar procedimentos de recuperação mais simples. Já um ambiente com RTO de poucos minutos exige arquitetura, automação, infraestrutura e procedimentos muito mais preparados.
RPO e RTO devem ser definidos individualmente para cada sistema. Não existe um único objetivo de recuperação adequado para todas as aplicações de uma organização.
PostgreSQL Enterprise Disaster Recovery e alta disponibilidade
Alta disponibilidade e disaster recovery são conceitos relacionados, mas não equivalentes.
Uma arquitetura de alta disponibilidade pode utilizar um servidor primário e um ou mais servidores standby. Em caso de falha do primário, um standby pode ser promovido para assumir a função de servidor principal.
O PostgreSQL documenta mecanismos de failover nos quais um servidor standby pode ser promovido quando o primário deixa de operar. Após a promoção, entretanto, o ambiente precisa ser reorganizado para retornar a uma topologia operacional com redundância.
Disaster recovery amplia esse conceito para cenários em que não é suficiente perder apenas um servidor. O objetivo passa a ser proteger a operação contra eventos que podem afetar todo o ambiente primário.
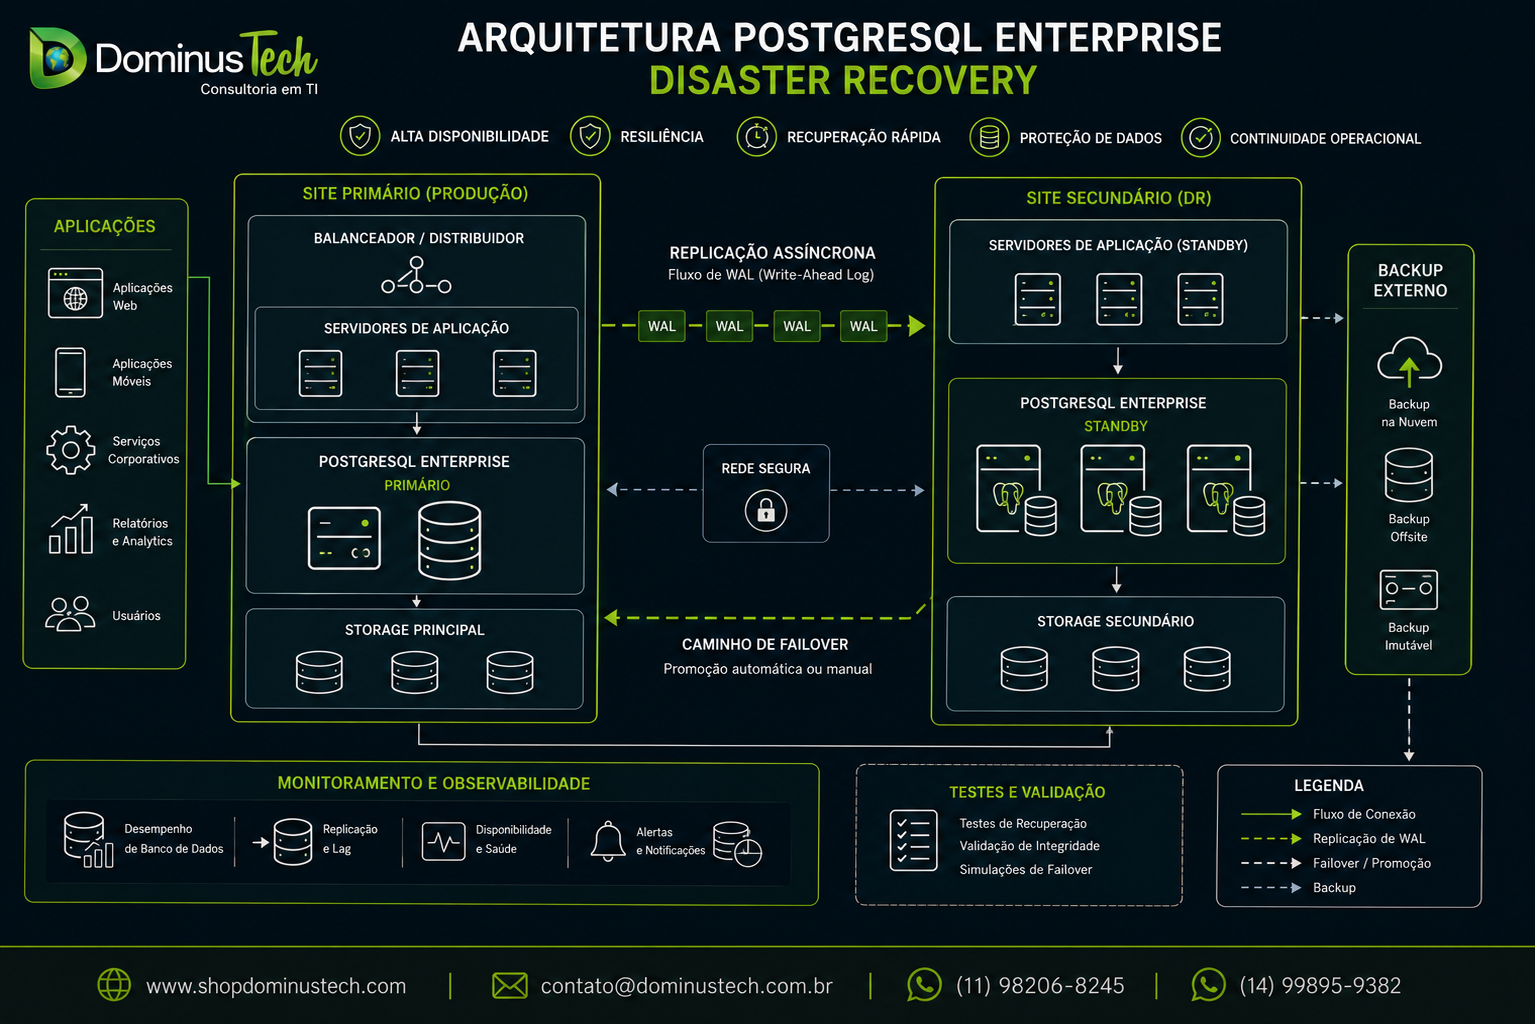
Arquitetura PostgreSQL Enterprise para Disaster Recovery
Uma arquitetura corporativa pode utilizar diferentes componentes, dependendo dos requisitos de negócio, orçamento, localização dos ambientes e objetivos de RPO e RTO.
Site primário
O site primário hospeda o ambiente PostgreSQL utilizado pelas aplicações em produção.
Normalmente inclui:
- Servidor ou cluster PostgreSQL.
- Storage de produção.
- Servidores de aplicação.
- Rede corporativa.
- Monitoramento.
- Infraestrutura de backup.
Site secundário
O site secundário funciona como ambiente de recuperação e pode estar localizado em outro data center, região ou infraestrutura de nuvem.
Dependendo da criticidade, esse ambiente pode permanecer permanentemente preparado para assumir a operação ou ser parcialmente provisionado e ativado durante uma situação de desastre.
Streaming Replication no Disaster Recovery
A Streaming Replication permite transmitir alterações do servidor PostgreSQL primário para servidores standby.
Essa arquitetura pode ser utilizada tanto para alta disponibilidade quanto como componente de uma estratégia de disaster recovery, desde que o ambiente secundário seja planejado para o cenário de recuperação.
Uma configuração típica pode conter:
- Um servidor PostgreSQL primário.
- Um ou mais servidores standby.
- Replicação física.
- Monitoramento do estado da replicação.
- Procedimentos de promoção.
- Processos para reconstrução do antigo primário.
A replicação reduz a distância entre o estado do banco primário e o ambiente secundário, mas não substitui backups independentes.
Por que replicação não substitui backup
Replicação mantém cópias das alterações do banco em outros servidores. Se uma alteração incorreta for propagada para o standby, entretanto, o problema pode atingir também a réplica.
Isso é especialmente importante em cenários como:
- Exclusão acidental de registros.
- Execução incorreta de comandos SQL.
- Alteração lógica indevida.
- Corrupção causada por aplicação.
- Erro administrativo.
- Comprometimento de credenciais.
- Incidentes de segurança.
Por esse motivo, uma estratégia completa combina replicação com backups independentes e mecanismos de recuperação em um ponto específico do tempo.
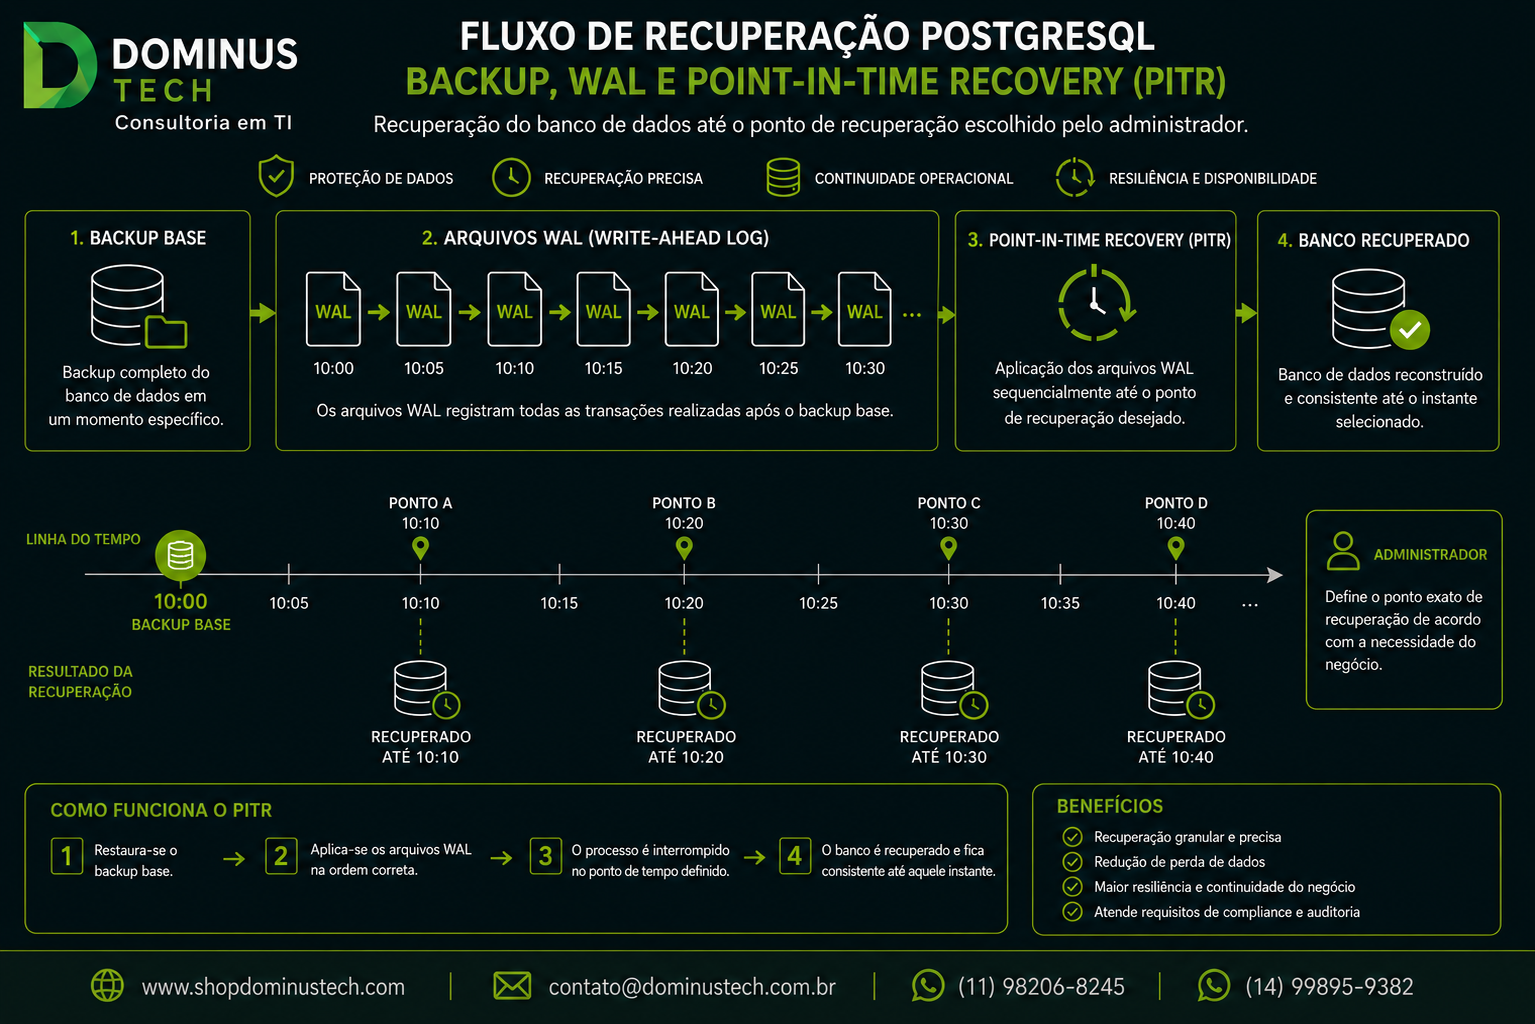
Backup e Point-in-Time Recovery
O Point-in-Time Recovery — PITR permite recuperar um banco PostgreSQL utilizando um backup base e os arquivos WAL necessários para reconstruir o estado do banco até determinado ponto.
Esse mecanismo é particularmente importante em disaster recovery porque permite tratar cenários em que o último backup completo não representa o estado desejado para recuperação.
Uma arquitetura de backup corporativa pode combinar:
- Backup completo.
- Backups incrementais.
- Arquivamento de WAL.
- Retenção definida por política.
- Armazenamento externo.
- Criptografia.
- Controle de acesso.
- Testes de restauração.
O pgBackRest é uma das ferramentas utilizadas no ecossistema PostgreSQL para implementar estratégias de backup e recuperação, incluindo cenários de disaster recovery. A documentação mantida pela EDB descreve sua utilização com PostgreSQL e EDB Postgres Advanced Server.
Disaster Recovery com PostgreSQL em outro data center
Para aplicações críticas, manter o ambiente de recuperação no mesmo local físico do ambiente primário pode não ser suficiente.
Um incidente capaz de afetar o data center inteiro pode comprometer simultaneamente:
- Servidores.
- Storage.
- Rede.
- Energia.
- Equipamentos de segurança.
- Sistemas de backup locais.
Por isso, arquiteturas de disaster recovery frequentemente utilizam uma segunda localização física ou lógica.
A distância entre os ambientes deve ser definida considerando requisitos de latência, largura de banda, legislação, segurança, custo e objetivo de recuperação.
PostgreSQL Enterprise Disaster Recovery em ambientes de nuvem
Ambientes de nuvem podem ser utilizados como destino de disaster recovery, permitindo separar fisicamente o ambiente secundário da infraestrutura de produção.
O ambiente pode utilizar máquinas virtuais, servidores dedicados, storage de objetos, redes privadas e serviços complementares, dependendo da estratégia adotada.
Mesmo em cloud, entretanto, os mesmos princípios permanecem válidos:
- Definição de RPO.
- Definição de RTO.
- Proteção dos backups.
- Replicação adequada.
- Controle de acesso.
- Monitoramento.
- Automação.
- Testes de recuperação.
Failover automático com EDB Failover Manager
Em ambientes PostgreSQL Enterprise, o EDB Failover Manager pode ser utilizado para monitorar clusters PostgreSQL e automatizar a promoção de um standby em determinados cenários de falha.
A documentação atual da EDB descreve o Failover Manager como uma ferramenta para gerenciamento de clusters PostgreSQL com arquiteturas primary-standby utilizando streaming replication, com suporte a failover automático.
O EDB Failover Manager também pode ser utilizado com PostgreSQL e EDB Postgres Advanced Server.
Em uma arquitetura de disaster recovery, o failover manager deve ser considerado como parte do mecanismo operacional de continuidade, e não como substituto de backup ou de um plano completo de recuperação.
Witness e prevenção de decisões incorretas
Dependendo da topologia, mecanismos adicionais podem ser utilizados para reduzir situações nas quais diferentes nós possam interpretar incorretamente o estado do cluster.
O PostgreSQL destaca a importância de mecanismos que evitem que dois servidores assumam simultaneamente a função de primário, situação que pode provocar inconsistência e perda de dados.
O EDB Failover Manager também possui suporte a arquiteturas com witness, além de mecanismos específicos para verificar condições de falha antes da promoção.
Failover, switchover e disaster recovery
Failover
Failover ocorre quando o ambiente primário deixa de operar e o standby é promovido para assumir a função principal.
Switchover
Switchover é uma mudança planejada de papéis entre primário e standby.
O switchover é particularmente importante para testes, manutenção e validação operacional da arquitetura de continuidade.
A documentação do EDB Failover Manager apresenta procedimentos para realizar switchover quando os nós estão adequadamente sincronizados.
Disaster Recovery
Disaster recovery representa o conjunto completo de processos necessários para recuperar a operação após um incidente de maior abrangência.
Assim, failover pode ser um mecanismo dentro do disaster recovery, mas não representa sozinho toda a estratégia.
Proteção contra corrupção lógica
Um plano de disaster recovery deve considerar não apenas falhas físicas, mas também falhas lógicas.
Uma infraestrutura pode permanecer tecnicamente disponível enquanto os dados são comprometidos por uma operação incorreta.
Por isso, políticas corporativas podem utilizar:
- Backups independentes.
- Retenção de múltiplos pontos de recuperação.
- WAL archiving.
- Ambientes isolados de backup.
- Controle de privilégios.
- Auditoria.
- Testes de restauração.
- Procedimentos de recuperação lógica.
Proteção contra ransomware e incidentes de segurança
Disaster recovery também precisa considerar cenários de comprometimento de segurança.
Se o atacante conseguir acesso ao ambiente principal e aos sistemas utilizados para administrar os backups, uma estratégia baseada exclusivamente em cópias conectadas ao ambiente de produção pode ser insuficiente.
Uma arquitetura mais resiliente pode utilizar:
- Credenciais separadas.
- Controle de acesso baseado em funções.
- Criptografia.
- Armazenamento isolado.
- Políticas de retenção.
- Backups fora do ambiente principal.
- Monitoramento de alterações.
- Testes periódicos de restauração.
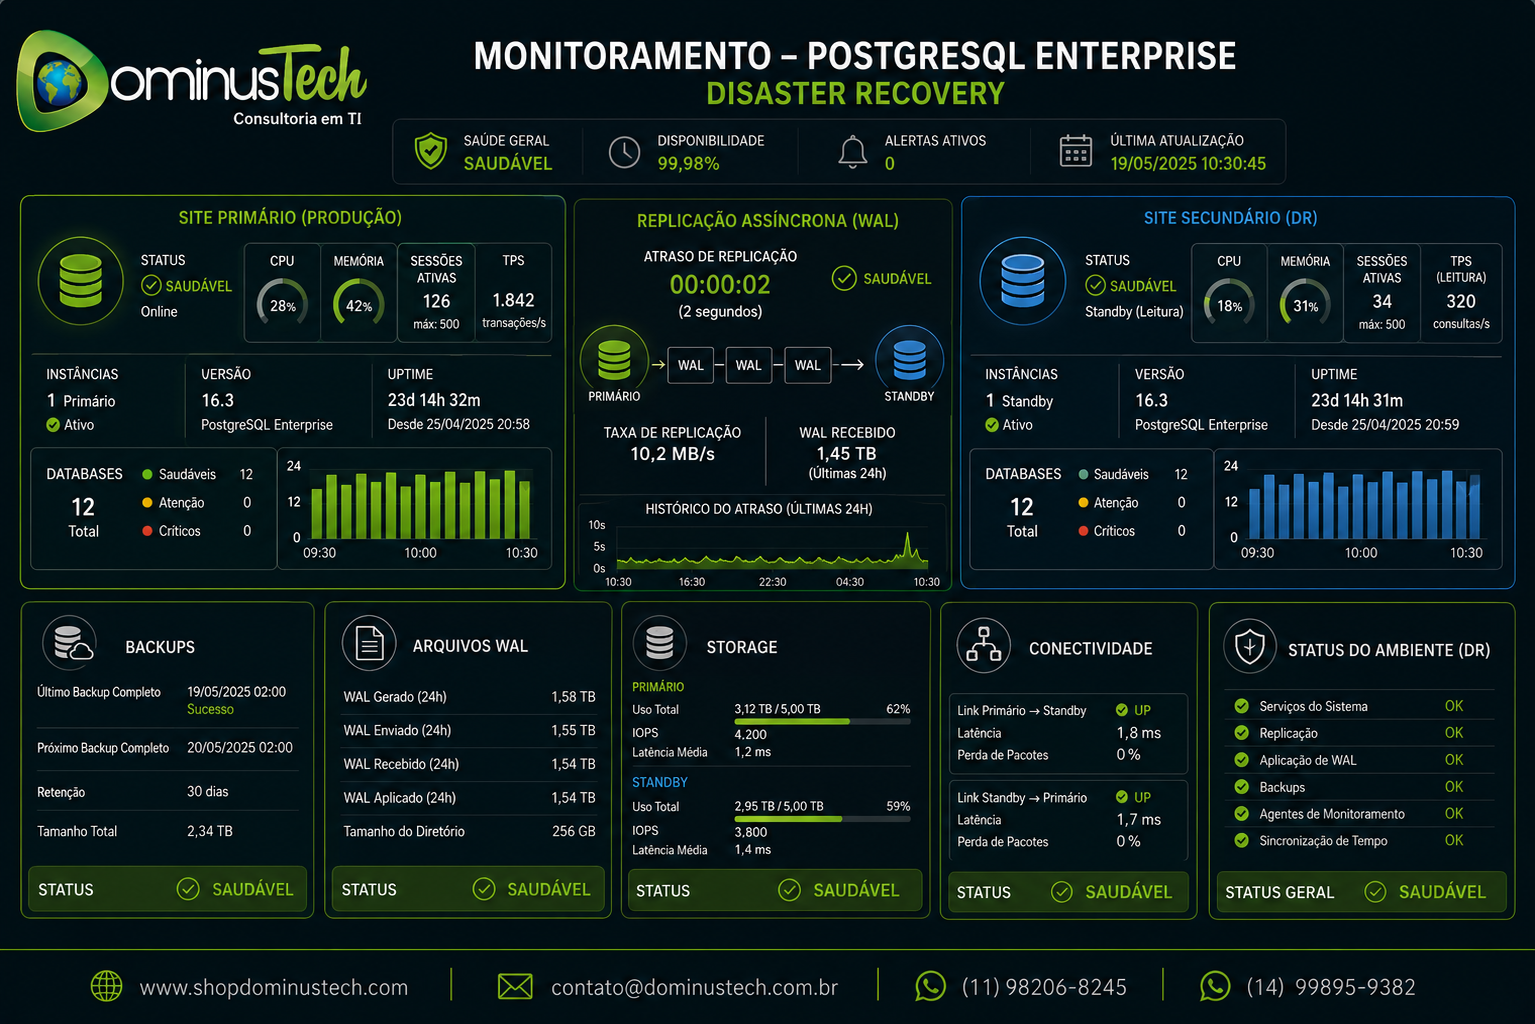
Monitoramento do ambiente de Disaster Recovery
Uma réplica que deixou de receber WAL sem que ninguém perceba não representa uma proteção efetiva.
O monitoramento deve acompanhar indicadores como:
- Status do servidor primário.
- Status dos servidores standby.
- Atraso de replicação.
- Estado do WAL.
- Falhas de backup.
- Capacidade de storage.
- Conectividade entre ambientes.
- Tempo desde o último backup válido.
- Integridade do repositório de backup.
- Estado dos agentes de failover.
O monitoramento deve gerar alertas acionáveis, permitindo que a equipe identifique uma degradação da proteção antes que um incidente real aconteça.
Testes de Disaster Recovery
Uma estratégia de recuperação não deve ser considerada validada apenas porque os backups foram configurados.
É necessário executar testes controlados para verificar se os procedimentos funcionam na prática.
Testes recomendados
- Restauração de backup.
- Point-in-Time Recovery.
- Promoção de standby.
- Switchover planejado.
- Perda do servidor primário.
- Perda do storage.
- Perda de conectividade entre sites.
- Recuperação de um banco específico.
- Recuperação completa do cluster.
- Reconstrução de um servidor standby.
- Validação da conexão das aplicações.
O teste também deve medir o tempo efetivamente gasto na recuperação. Dessa forma, a organização consegue comparar o resultado real com o RTO definido.
Runbook de recuperação PostgreSQL Enterprise
Ambientes críticos devem possuir procedimentos documentados para os principais cenários de incidente.
Um runbook pode incluir:
- Critérios para declarar um desastre.
- Responsáveis pela tomada de decisão.
- Procedimentos de isolamento do ambiente afetado.
- Procedimento de promoção do standby.
- Procedimento de ativação do site secundário.
- Procedimento de recuperação por backup.
- Procedimento de Point-in-Time Recovery.
- Procedimento de validação dos dados.
- Procedimento de reconexão das aplicações.
- Procedimento de comunicação com as equipes envolvidas.
- Procedimento para reconstrução do ambiente original.
- Procedimento de retorno à operação normal.
Arquitetura síncrona versus assíncrona
Replicação síncrona
Na replicação síncrona, a confirmação da transação pode depender da confirmação do standby configurado para sincronização.
Essa abordagem pode reduzir o risco de perda de dados, mas introduz dependência da comunicação entre os ambientes e pode aumentar a latência das operações.
Replicação assíncrona
Na replicação assíncrona, o primário não precisa aguardar a confirmação do standby para concluir a transação da mesma forma que ocorre em uma configuração síncrona.
Essa abordagem pode ser mais adequada para ambientes geograficamente distantes, onde a latência entre sites é relevante.
A escolha deve considerar o RPO, a distância entre os ambientes, a largura de banda e os requisitos da aplicação.
Disaster Recovery para ambientes PostgreSQL críticos
Quanto maior a criticidade da aplicação, maior deve ser o nível de rigor aplicado ao planejamento da recuperação.
Um ambiente de missão crítica normalmente exige uma combinação de:
- Alta disponibilidade.
- Replicação.
- Backups independentes.
- WAL archiving.
- Point-in-Time Recovery.
- Ambiente secundário.
- Monitoramento.
- Automação de failover.
- Segurança.
- Testes periódicos.
- Runbooks documentados.
O nível de proteção deve ser proporcional ao impacto financeiro e operacional causado pela indisponibilidade do sistema.
PostgreSQL Enterprise Disaster Recovery com EDB
Em ambientes que utilizam tecnologias EnterpriseDB, a estratégia pode combinar PostgreSQL ou EDB Postgres Advanced Server com ferramentas voltadas à alta disponibilidade, backup, recuperação e gerenciamento operacional.
O ecossistema EDB oferece componentes como Failover Manager, além de suporte a tecnologias de backup e recuperação utilizadas em ambientes PostgreSQL Enterprise. A EDB também documenta diferentes arquiteturas de alta disponibilidade e ferramentas relacionadas ao ciclo operacional do PostgreSQL.
Em arquiteturas distribuídas, o EDB Postgres Distributed também possui mecanismos específicos para ambientes distribuídos e cenários de recuperação, incluindo padrões com grupo primário e grupo de disaster recovery.
Como estruturar um projeto de PostgreSQL Enterprise Disaster Recovery
1. Identificação das aplicações críticas
O primeiro passo é identificar quais sistemas dependem do PostgreSQL e qual o impacto de sua indisponibilidade.
2. Definição de RPO e RTO
Cada aplicação deve receber objetivos de recuperação compatíveis com seu nível de criticidade.
3. Avaliação da arquitetura atual
Devem ser analisados servidores, storage, rede, replicação, backups, monitoramento, segurança e dependências externas.
4. Definição da arquitetura secundária
A organização deve definir onde o ambiente de recuperação será executado e quais recursos serão necessários.
5. Implementação da replicação
A replicação deve ser configurada de acordo com o RPO e as características da infraestrutura.
6. Implementação de backup e recuperação
Backups devem possuir política de retenção, armazenamento apropriado e procedimentos de restauração.
7. Automação
Quando apropriado, tarefas de failover, monitoramento e recuperação podem ser automatizadas.
8. Testes
O ambiente deve ser submetido a testes controlados para validar os procedimentos.
9. Documentação
Todos os procedimentos críticos devem estar documentados e disponíveis para a equipe responsável.
Principais riscos de um projeto de Disaster Recovery PostgreSQL
- Replicação configurada, mas não monitorada.
- Backups armazenados somente no ambiente primário.
- Backups nunca restaurados em testes.
- RPO definido sem considerar a capacidade real de replicação.
- RTO definido sem medir o tempo de recuperação.
- Dependência de procedimentos manuais não documentados.
- Ausência de ambiente secundário.
- Credenciais compartilhadas entre produção e backup.
- Ausência de testes de failover.
- Aplicações sem procedimento para reconexão.
- Falta de monitoramento do atraso de replicação.
- Ausência de testes de recuperação após mudanças de infraestrutura.
PostgreSQL Enterprise Disaster Recovery e continuidade de negócios
O disaster recovery do PostgreSQL deve fazer parte de uma estratégia maior de continuidade de negócios.
O banco de dados é apenas um dos componentes necessários para que uma aplicação volte a operar.
Também devem ser avaliados:
- Servidores de aplicação.
- Serviços de autenticação.
- DNS.
- Load balancers.
- Storage.
- Filas.
- Integrações.
- Certificados.
- Credenciais.
- Redes.
- Serviços externos.
Uma recuperação bem-sucedida do PostgreSQL não garante automaticamente que a aplicação esteja novamente operacional. Por isso, os testes devem considerar a cadeia completa do serviço.
Quando implementar PostgreSQL Enterprise Disaster Recovery
Uma estratégia formal de disaster recovery deve ser considerada especialmente quando o PostgreSQL sustenta sistemas cuja indisponibilidade pode provocar impacto significativo sobre operações, clientes, receitas, processos internos ou requisitos regulatórios.
Alguns exemplos incluem:
- Sistemas financeiros.
- ERP.
- Sistemas de atendimento.
- Aplicações transacionais.
- Plataformas digitais.
- Sistemas de integração.
- Aplicações de missão crítica.
- Ambientes com requisitos de continuidade operacional.
FAQ — Perguntas Frequentes
O que é PostgreSQL Enterprise Disaster Recovery?
É a estratégia de tecnologias, processos e procedimentos utilizada para recuperar ambientes PostgreSQL corporativos após falhas graves, perda de infraestrutura, corrupção de dados ou indisponibilidade do ambiente principal.
Disaster Recovery é a mesma coisa que backup PostgreSQL?
Não. Backup é um componente do disaster recovery. Uma estratégia completa também pode envolver replicação, standby, WAL archiving, Point-in-Time Recovery, ambiente secundário, failover, monitoramento e testes.
Replicação PostgreSQL substitui backup?
Não. A replicação mantém uma cópia operacional dos dados, enquanto backups independentes permitem recuperar informações em situações como erro lógico, exclusão acidental ou corrupção.
O que significa RPO?
RPO é o Recovery Point Objective e representa a quantidade máxima de dados que a organização aceita perder em um incidente.
O que significa RTO?
RTO é o Recovery Time Objective e representa o tempo máximo definido para recuperação de determinado serviço após uma interrupção.
É possível utilizar PostgreSQL Enterprise Disaster Recovery em outro data center?
Sim. Uma arquitetura pode utilizar um ambiente secundário em outra localização física ou infraestrutura de nuvem, dependendo dos requisitos de RPO, RTO, conectividade, segurança e orçamento.
O EDB Failover Manager pode fazer parte da estratégia de Disaster Recovery?
Sim. O EDB Failover Manager pode ser utilizado para monitoramento e failover de clusters PostgreSQL e EDB Postgres Advanced Server. Ele deve ser tratado como parte da arquitetura de alta disponibilidade e continuidade, não como substituto de backup e recuperação.
É necessário testar o Disaster Recovery?
Sim. Testes de restauração, failover, switchover e recuperação completa são importantes para validar se os procedimentos realmente atendem aos objetivos de RPO e RTO.
PostgreSQL pode ser utilizado em ambientes de missão crítica com Disaster Recovery?
Sim. PostgreSQL pode ser implementado em arquiteturas corporativas que utilizam replicação, alta disponibilidade, backup, recuperação, monitoramento e ambientes secundários, de acordo com os requisitos técnicos e operacionais da organização.
Links Relacionados
- Disaster Recovery PostgreSQL
- Alta Disponibilidade PostgreSQL
- Cluster PostgreSQL
- Replicação PostgreSQL
- Failover PostgreSQL
- Backup PostgreSQL
- PostgreSQL para Missão Crítica
- PostgreSQL Corporativo
- Suporte Corporativo PostgreSQL
Recursos Oficiais
- Documentação oficial do PostgreSQL
- PostgreSQL — Warm Standby
- PostgreSQL — Failover
- PostgreSQL — High Availability, Load Balancing and Replication
- EDB Failover Manager
- EDB Failover Manager — Quick Start
- EDB — pgBackRest
- EDB — High Availability
Modernize seu Banco de Dados com a Dominus Tech
👉 Planejando uma Migração Oracle para PostgreSQL?
A Dominus Tech é Parceira Gold da EnterpriseDB e apoia empresas em todas as etapas da modernização de bancos de dados Oracle para PostgreSQL. Nossa equipe atua em assessment, planejamento, análise de compatibilidade, arquitetura, migração, otimização de desempenho, alta disponibilidade, observabilidade e suporte especializado para ambientes PostgreSQL Enterprise.
✔ Parceira Gold da EnterpriseDB no Brasil
O planejamento adequado permite transformar uma migração complexa em um projeto estruturado, com riscos identificados, responsabilidades definidas, critérios de sucesso e estratégia de execução. A Dominus Tech pode apoiar sua organização desde a avaliação inicial até a estabilização do ambiente PostgreSQL em produção.