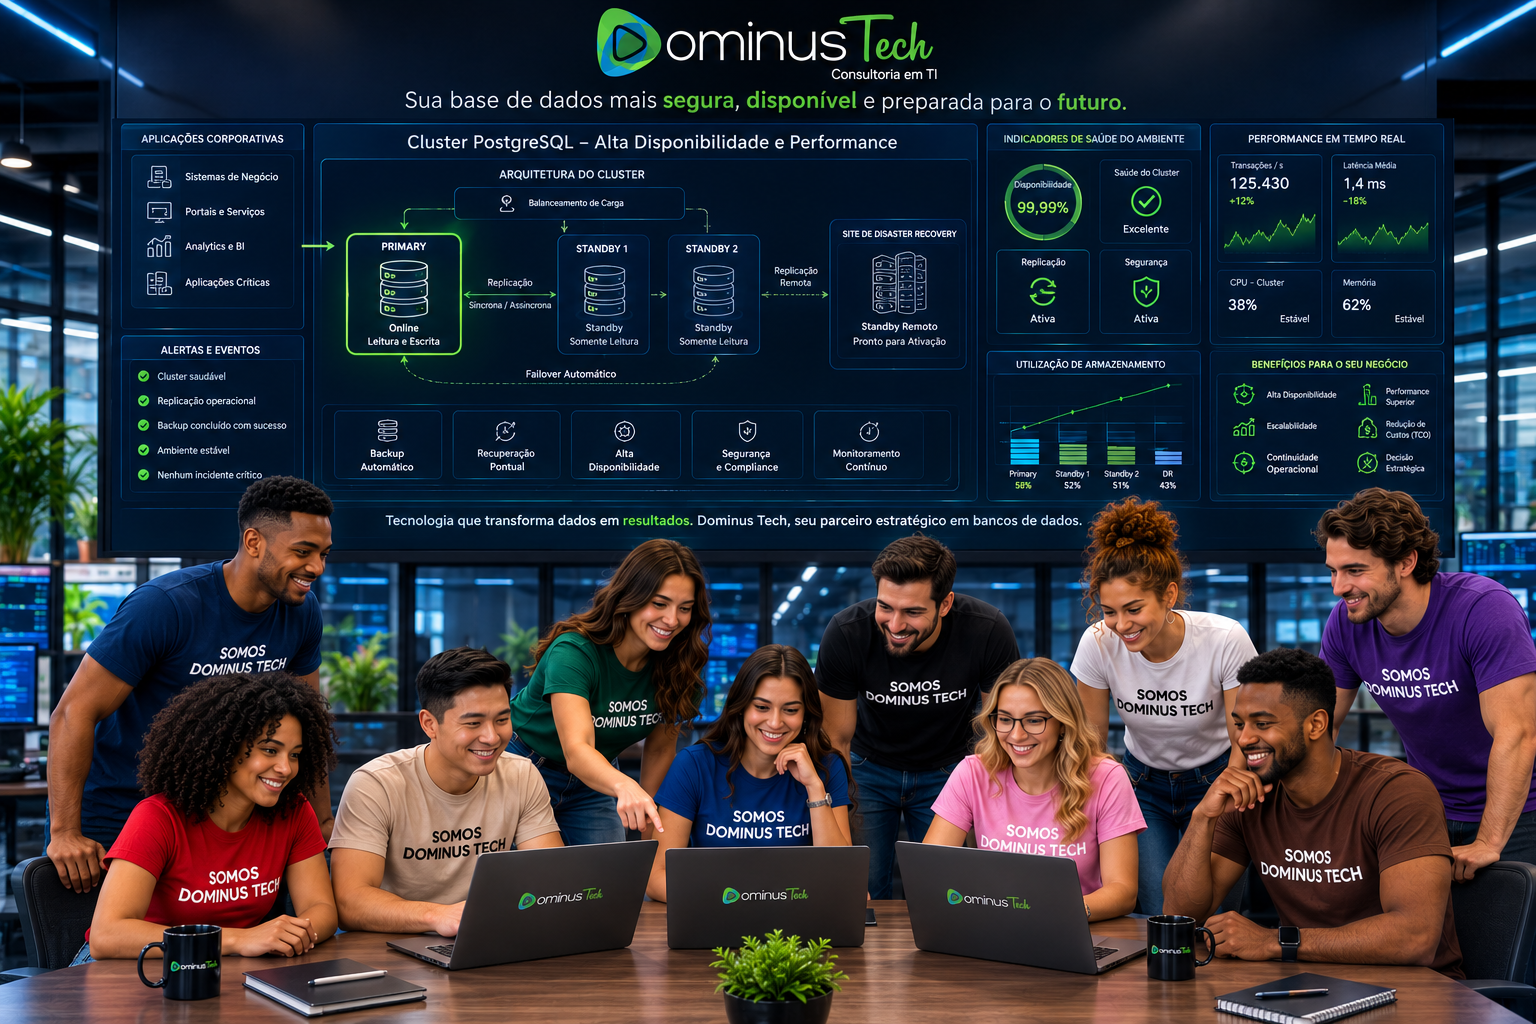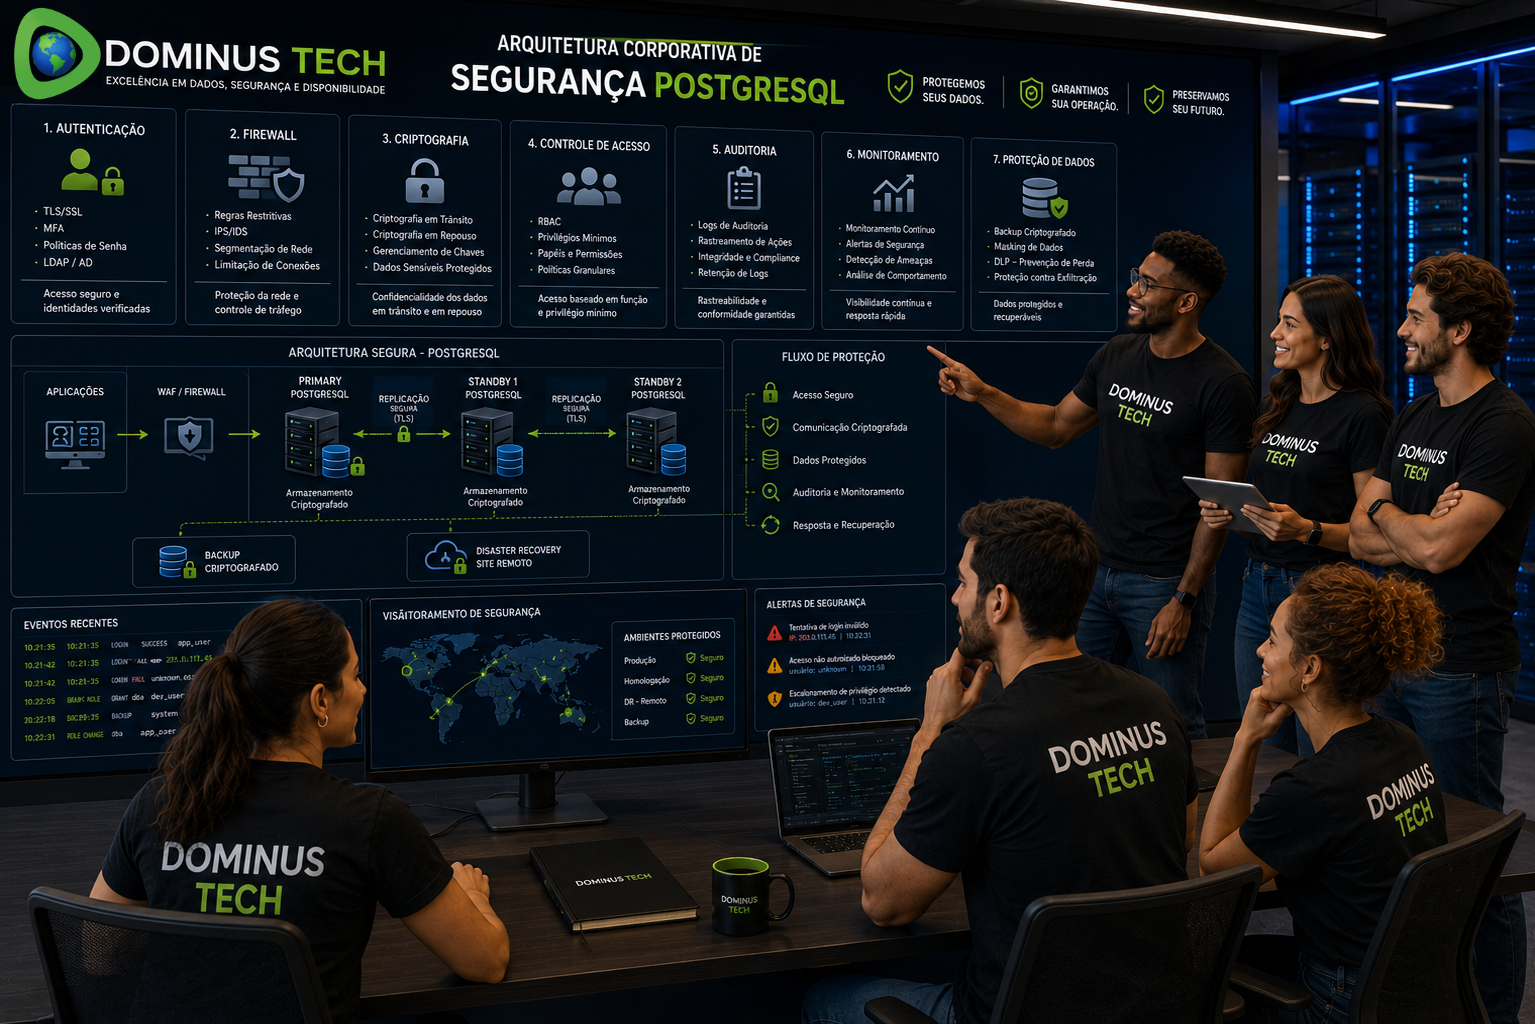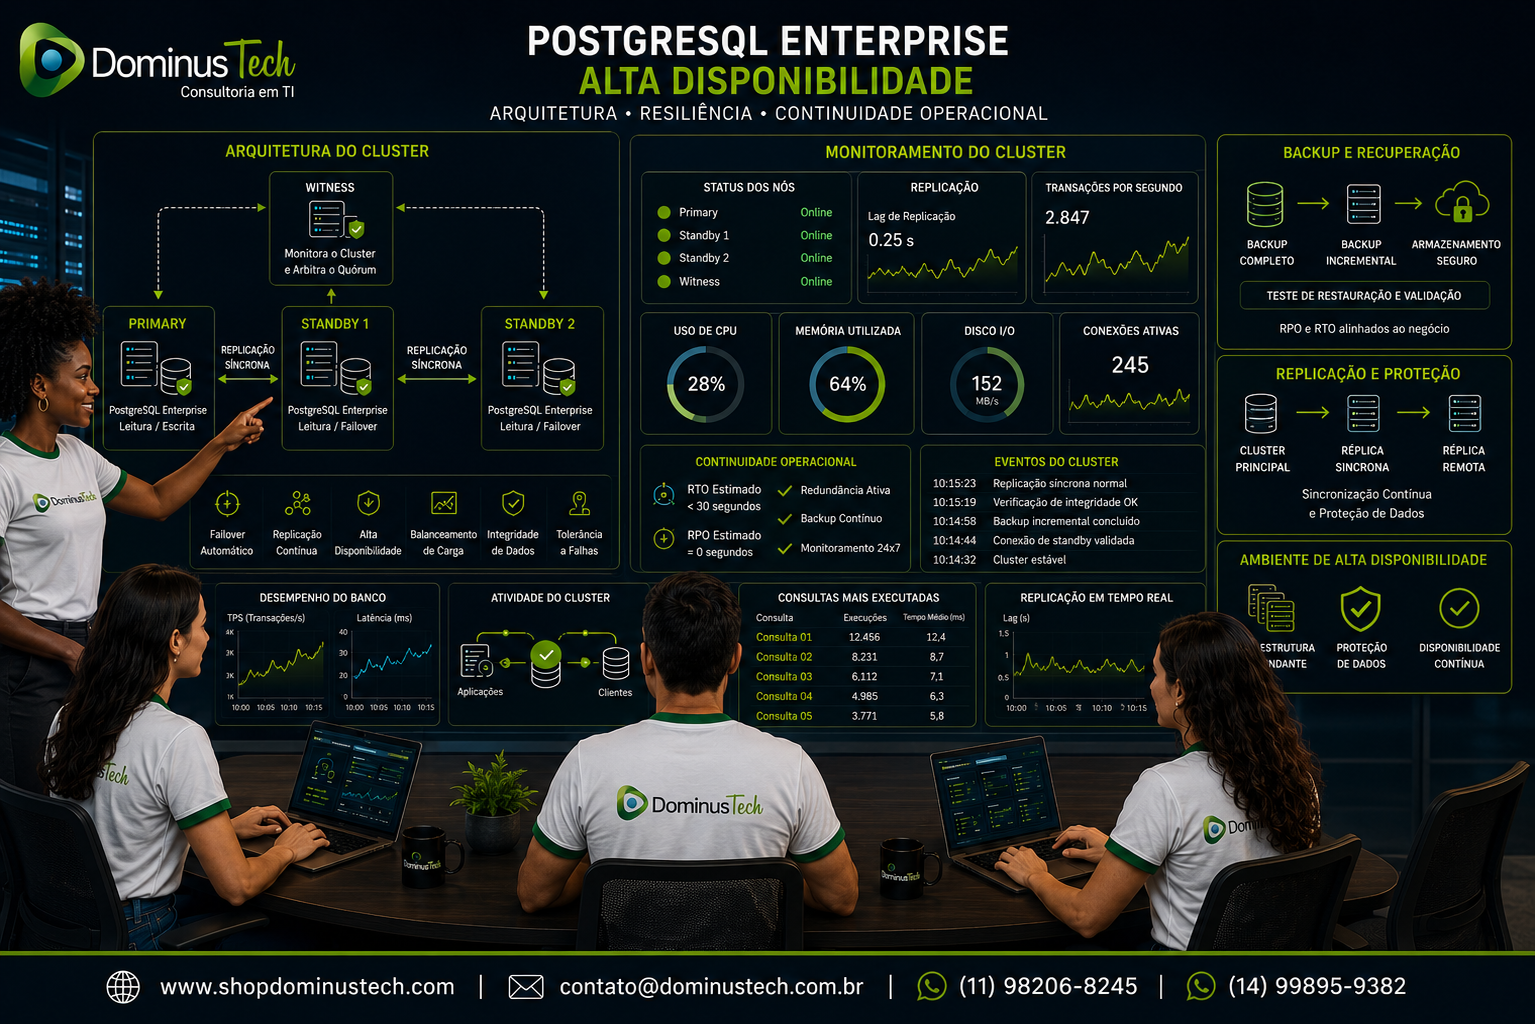
PostgreSQL Enterprise Alta Disponibilidade: Arquitetura, Cluster, Failover e Continuidade Operacional
PostgreSQL Enterprise Alta Disponibilidade é uma arquitetura projetada para manter bancos de dados PostgreSQL disponíveis mesmo diante de falhas de servidores, armazenamento, rede, componentes de infraestrutura ou indisponibilidade de um nó do ambiente. Em aplicações corporativas e ambientes de missão crítica, alta disponibilidade não significa apenas manter um segundo servidor disponível, mas estruturar mecanismos de replicação, detecção de falhas, failover, recuperação e operação capazes de reduzir o impacto de incidentes sobre os sistemas de negócio.
À medida que o PostgreSQL passa a suportar sistemas transacionais, aplicações corporativas, plataformas digitais e workloads críticos, a arquitetura de disponibilidade precisa ser planejada considerando requisitos de RTO, RPO, capacidade, replicação, armazenamento, rede, monitoramento e procedimentos operacionais. Em ambientes PostgreSQL Enterprise, essas decisões também podem envolver recursos adicionais fornecidos por plataformas empresariais, como EnterpriseDB, ferramentas de gerenciamento, mecanismos de failover e recursos de suporte.
O que é PostgreSQL Enterprise Alta Disponibilidade
PostgreSQL Enterprise Alta Disponibilidade é o conjunto de componentes, processos e práticas utilizados para manter um serviço de banco de dados PostgreSQL operacional mesmo quando ocorre uma falha em parte da infraestrutura.
Uma arquitetura de alta disponibilidade normalmente utiliza um servidor PostgreSQL primário e um ou mais servidores secundários, chamados de réplicas ou standbys. As alterações realizadas no primário são enviadas para os servidores secundários por meio dos mecanismos de replicação do PostgreSQL.
Quando ocorre uma falha no servidor primário, a arquitetura pode realizar a promoção de uma réplica para assumir a função de servidor principal. Dependendo do projeto, esse processo pode ser manual, semiautomático ou automatizado.
Em ambientes corporativos, entretanto, alta disponibilidade não deve ser tratada apenas como uma configuração de replicação. É necessário considerar também:
- Detecção de falhas
- Replicação dos dados
- Promoção de servidores
- Failover
- Reconfiguração de aplicações
- Balanceamento de conexões
- Monitoramento
- Backup
- Disaster Recovery
- Testes periódicos
- Procedimentos operacionais
- Segurança
Por que alta disponibilidade é importante em ambientes PostgreSQL Enterprise
A indisponibilidade de um banco de dados pode interromper aplicações inteiras. Sistemas de ERP, plataformas financeiras, aplicações comerciais, sistemas de atendimento, portais corporativos e plataformas digitais frequentemente dependem do banco de dados como componente central.
Quando o PostgreSQL é utilizado como plataforma empresarial, a disponibilidade do banco passa a ser diretamente relacionada à continuidade dos serviços de negócio.
Uma arquitetura de alta disponibilidade permite reduzir o risco associado a falhas isoladas e criar mecanismos para recuperação mais rápida do serviço.
Entre os principais objetivos estão:
- Reduzir o tempo de indisponibilidade
- Reduzir o impacto de falhas de infraestrutura
- Permitir recuperação rápida do serviço
- Manter cópias atualizadas dos dados
- Reduzir pontos únicos de falha
- Aumentar a resiliência da plataforma
- Facilitar procedimentos de failover
- Suportar requisitos corporativos de continuidade
Arquitetura típica de PostgreSQL Enterprise Alta Disponibilidade
Uma arquitetura tradicional pode ser formada por um servidor PostgreSQL primário conectado a uma ou mais réplicas.
O servidor primário recebe as operações de escrita. As alterações são registradas no mecanismo de Write-Ahead Logging e enviadas para os servidores standby por meio da replicação.
As réplicas podem ser utilizadas para recuperação em caso de falha e, dependendo da arquitetura, também podem atender determinados workloads de leitura.
Uma arquitetura corporativa pode incluir ainda uma camada de conexão ou balanceamento responsável por direcionar as aplicações para o servidor atualmente ativo.
Em termos conceituais, a arquitetura pode ser organizada da seguinte maneira:
- Aplicações corporativas
- Camada de conexão ou balanceamento
- Servidor PostgreSQL primário
- Servidor PostgreSQL standby
- Servidor PostgreSQL standby adicional
- Monitoramento
- Gerenciamento de failover
- Backup
- Site ou ambiente de Disaster Recovery
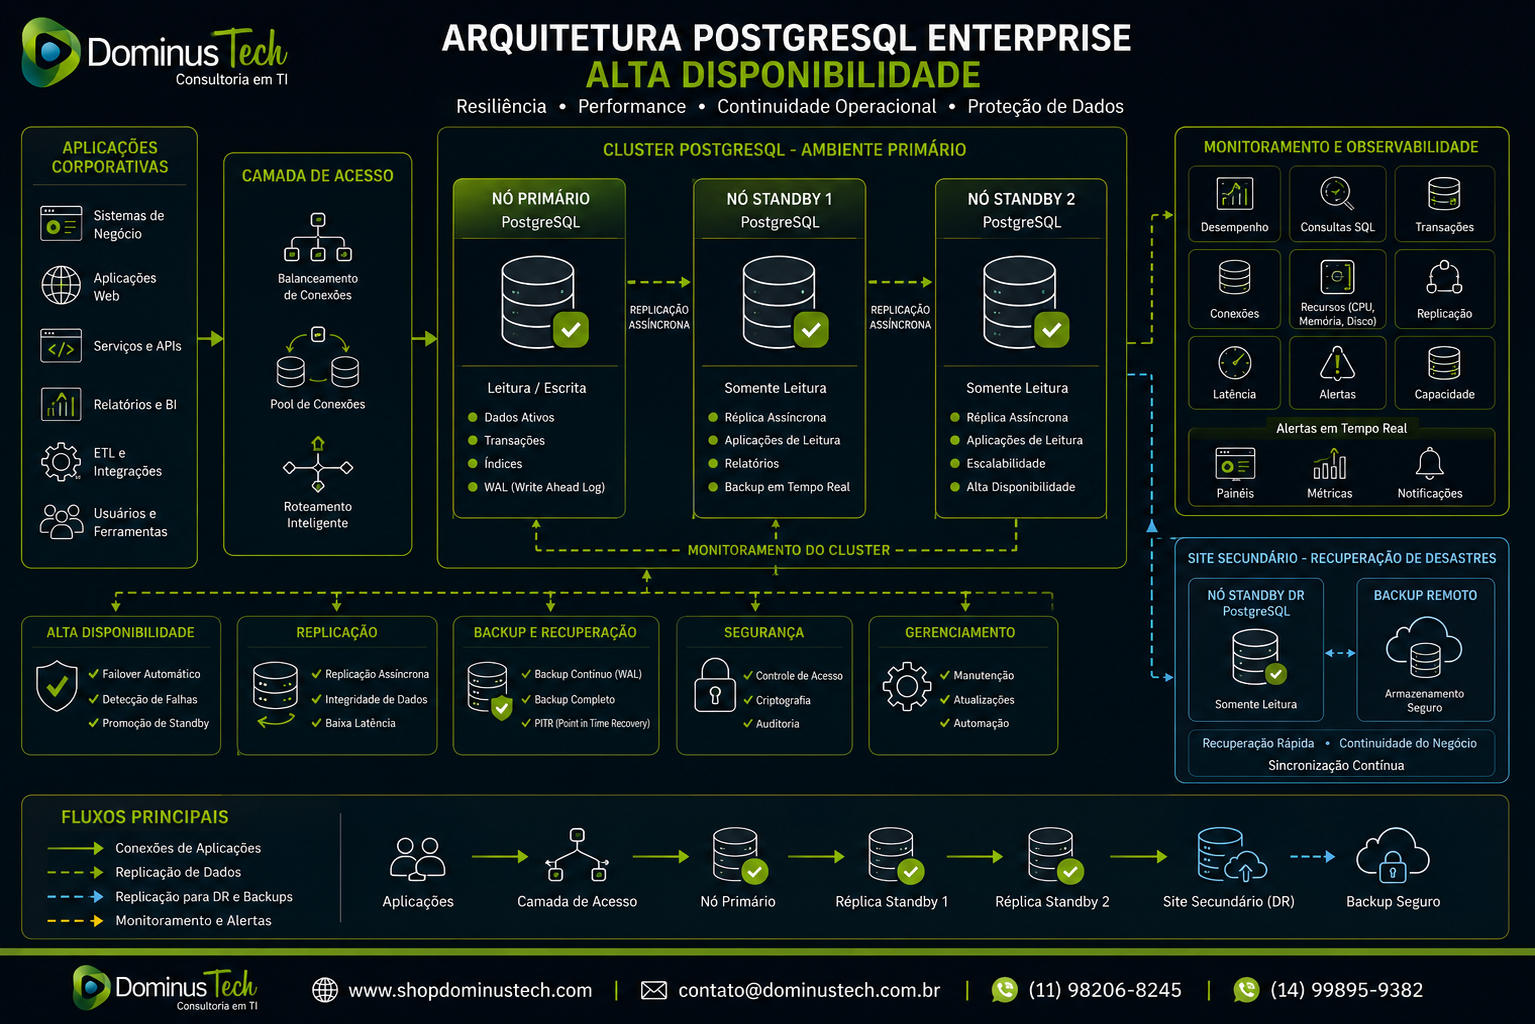
Arquitetura PostgreSQL Enterprise com servidor primário, réplicas standby, replicação contínua, monitoramento e ambiente de recuperação para alta disponibilidade.
PostgreSQL Primary e Standby
O modelo Primary/Standby é uma das bases das arquiteturas de alta disponibilidade PostgreSQL.
O servidor Primary é responsável pelas operações principais do banco de dados. O servidor Standby mantém uma cópia dos dados recebidos por meio da replicação.
Quando o Primary apresenta uma falha, um Standby pode ser promovido para assumir a função de novo Primary.
Essa arquitetura permite separar o conceito de servidor ativo do conceito de cópia de recuperação, criando uma camada adicional de resiliência.
Primary
O Primary normalmente concentra as operações de escrita e representa o ponto principal de acesso ao banco de dados.
Standby
O Standby recebe alterações do Primary e mantém uma cópia sincronizada ou próxima da sincronização, dependendo do modelo de replicação configurado.
Promoção
A promoção transforma um servidor Standby em servidor operacional para assumir o papel de Primary.
Replicação PostgreSQL na alta disponibilidade
A replicação é um dos componentes fundamentais de uma arquitetura PostgreSQL Enterprise Alta Disponibilidade.
O PostgreSQL utiliza mecanismos baseados em WAL para transportar as alterações do banco de dados para servidores standby.
O projeto da replicação precisa considerar a distância entre os servidores, latência de rede, volume de transações, capacidade de armazenamento e requisitos de RPO.
Em ambientes corporativos, é importante avaliar também a velocidade com que a réplica consegue aplicar as alterações recebidas.
Uma réplica atrasada pode reduzir a efetividade da arquitetura de alta disponibilidade porque, em caso de falha, pode não possuir as alterações mais recentes.
Por isso, o monitoramento do estado da replicação é uma parte essencial da operação.
Replicação síncrona e assíncrona
O PostgreSQL suporta diferentes estratégias de replicação, incluindo cenários de replicação síncrona e assíncrona.
Replicação assíncrona
Na replicação assíncrona, o Primary pode confirmar determinadas operações antes que elas tenham sido aplicadas no Standby.
Esse modelo normalmente oferece maior flexibilidade e menor impacto de latência, mas pode existir uma janela na qual alterações ainda não tenham chegado à réplica.
Replicação síncrona
Na replicação síncrona, o processamento pode depender da confirmação de um servidor standby conforme a política configurada.
Esse modelo pode reduzir a possibilidade de perda de dados em determinados cenários, porém introduz dependência maior da comunicação entre os servidores.
A escolha entre replicação síncrona e assíncrona deve considerar principalmente os requisitos de RPO, latência e disponibilidade da aplicação.
RPO e RTO em PostgreSQL Enterprise
Uma arquitetura de alta disponibilidade deve ser projetada a partir dos objetivos de continuidade do negócio.
RPO — Recovery Point Objective
RPO representa a quantidade máxima de dados que a organização aceita perder após uma falha.
Por exemplo, uma aplicação com RPO próximo de zero possui requisitos muito mais rigorosos do que uma aplicação que aceita perder alguns minutos de alterações.
RTO — Recovery Time Objective
RTO representa o tempo máximo aceitável para recuperar o serviço.
Quanto menor o RTO exigido, mais estruturada precisa ser a arquitetura de detecção de falhas, promoção, redirecionamento das conexões e validação do serviço.
Alta disponibilidade, portanto, deve ser dimensionada de acordo com RPO e RTO, e não simplesmente pela quantidade de servidores disponíveis.
Failover PostgreSQL Enterprise
Failover é o processo de transferência do serviço de banco de dados de um servidor que apresentou falha para outro servidor disponível.
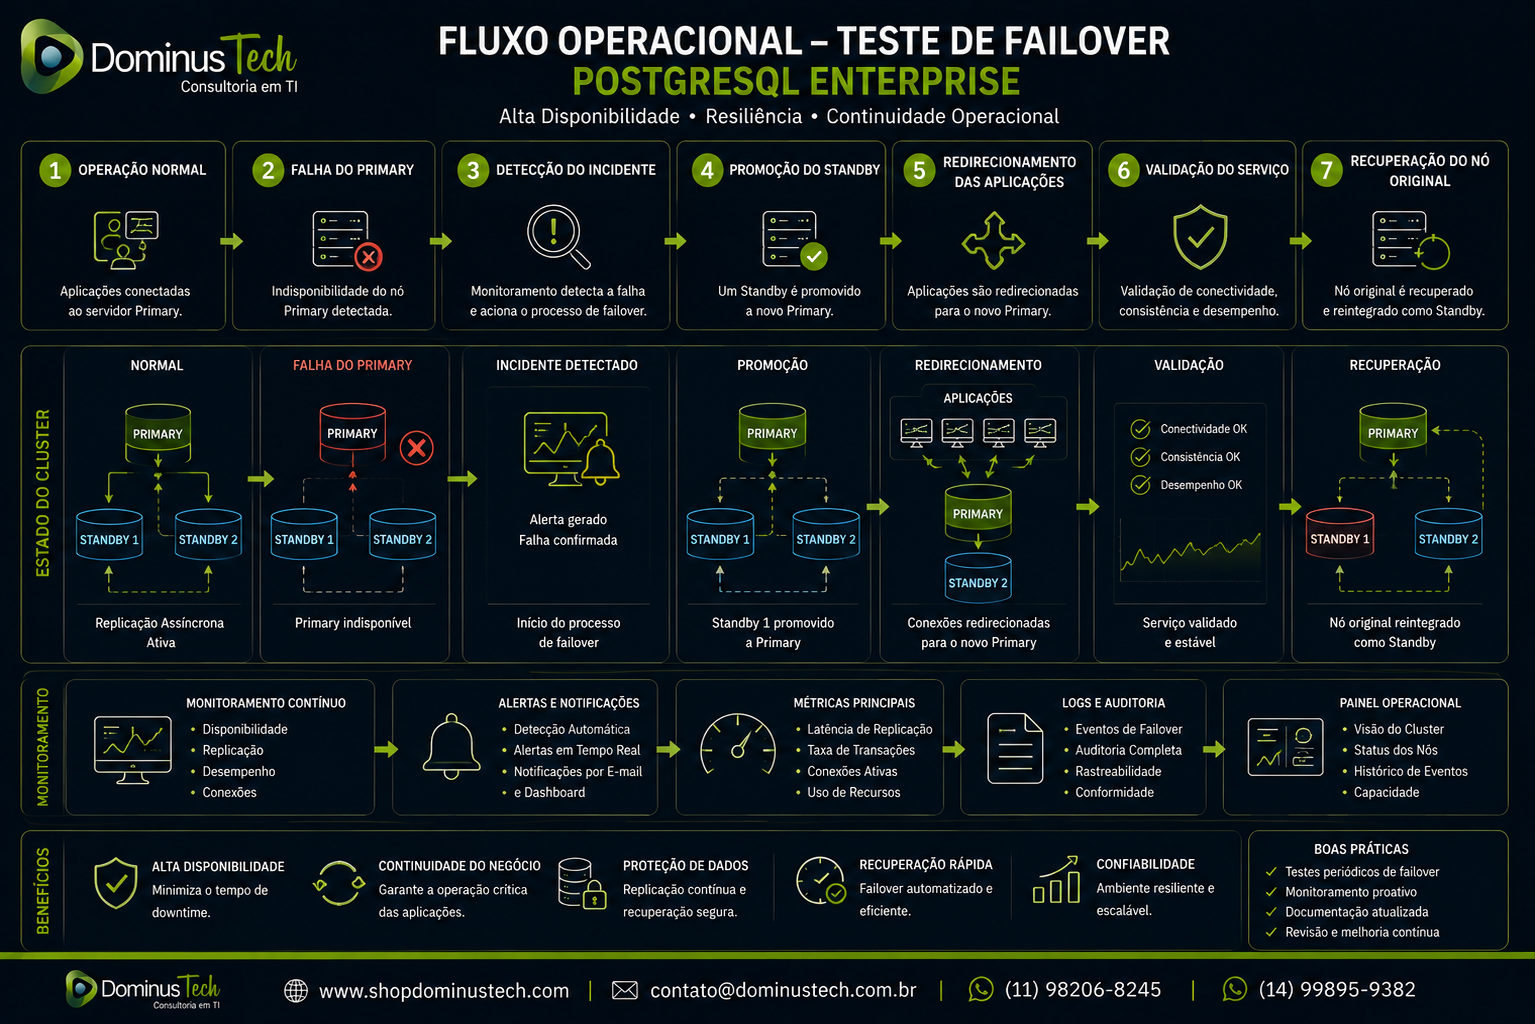
Em uma arquitetura PostgreSQL Enterprise, o failover pode envolver diversas etapas:
- Identificação da falha
- Validação do estado do Primary
- Seleção da réplica adequada
- Promoção do Standby
- Redirecionamento das conexões
- Validação da aplicação
- Monitoramento do novo Primary
- Recuperação do servidor que apresentou falha
O failover automático pode reduzir significativamente o tempo de recuperação, mas precisa ser implementado com mecanismos capazes de evitar decisões incorretas.
Risco de split-brain
Um dos principais riscos em ambientes de alta disponibilidade é o chamado split-brain, situação em que dois servidores podem ser considerados Primary simultaneamente.
Esse cenário pode provocar divergência de dados e conflitos operacionais.
Por esse motivo, uma arquitetura corporativa precisa utilizar mecanismos de controle, quorum, fencing ou outros métodos adequados ao desenho da infraestrutura.
EDB Failover Manager em arquiteturas PostgreSQL Enterprise
Em ambientes baseados em EnterpriseDB, o EDB Failover Manager pode ser utilizado para implementar mecanismos de monitoramento e gerenciamento de failover em clusters PostgreSQL.
O objetivo de uma ferramenta desse tipo é automatizar determinadas operações relacionadas à detecção de falhas, eleição ou promoção de servidores e recuperação do ambiente.
A utilização de uma ferramenta de failover deve ser acompanhada por um projeto de arquitetura que considere rede, armazenamento, quorum, conectividade das aplicações e procedimentos de recuperação.
Alta disponibilidade não substitui backup
Um dos erros mais comuns em projetos de alta disponibilidade é considerar que uma réplica substitui o backup.
Replicação e backup possuem objetivos diferentes.
A replicação mantém cópias dos dados disponíveis em outros servidores. Um backup permite recuperar informações em situações como exclusões acidentais, corrupção lógica, erros operacionais, ataques e outros incidentes que podem ser propagados para as réplicas.
Uma arquitetura PostgreSQL Enterprise deve combinar:
- Alta disponibilidade
- Replicação
- Backup
- Disaster Recovery
- Monitoramento
- Testes de recuperação
Essa combinação cria uma estratégia mais completa de proteção do ambiente.
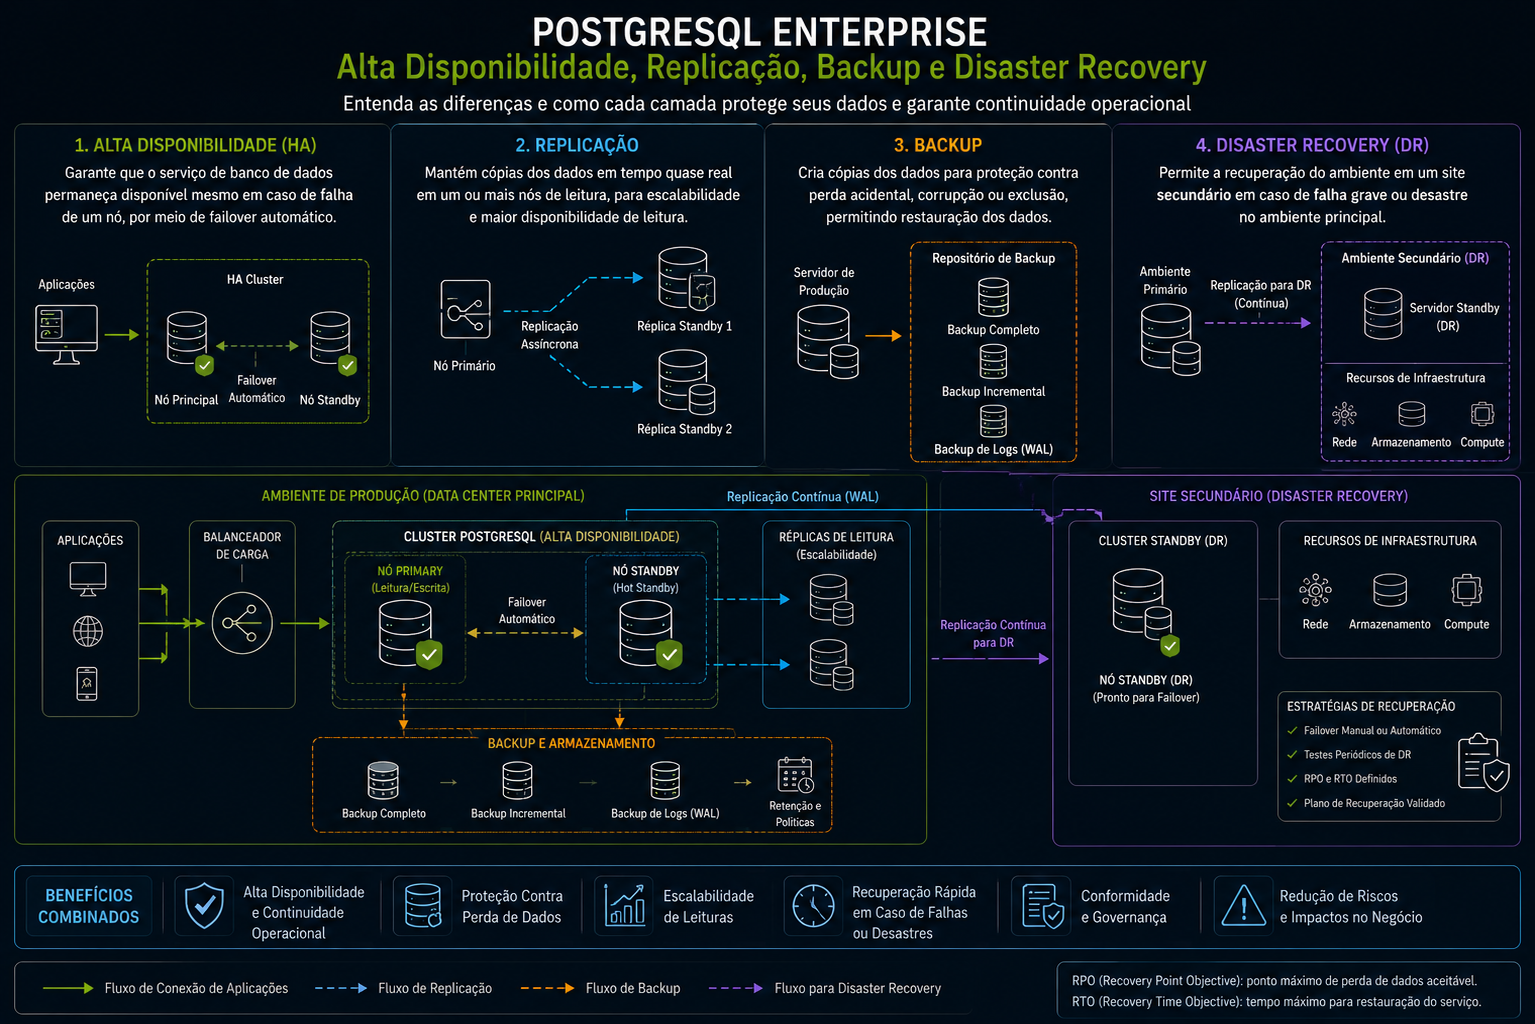
Arquitetura PostgreSQL Enterprise integrando alta disponibilidade, replicação, backup e Disaster Recovery para proteção de dados e continuidade operacional.
PostgreSQL Enterprise Alta Disponibilidade e Disaster Recovery
Alta disponibilidade e Disaster Recovery são conceitos relacionados, mas não são equivalentes.
Alta disponibilidade normalmente busca manter o serviço disponível diante de falhas dentro do ambiente principal.
Disaster Recovery busca recuperar o serviço diante de eventos de maior impacto, como perda de infraestrutura, indisponibilidade de um site, falhas generalizadas ou incidentes que afetem todo o ambiente de produção.
Uma estratégia corporativa pode combinar um cluster de alta disponibilidade no site principal com uma réplica ou ambiente de recuperação em outro local.
Site principal
O ambiente principal concentra os servidores utilizados pelas aplicações de produção.
Site secundário
O site secundário mantém recursos capazes de suportar a recuperação da operação caso o ambiente principal fique indisponível.
Replicação entre sites
A replicação entre sites pode ser utilizada para manter os dados disponíveis no ambiente secundário, considerando os requisitos de RPO e a capacidade da infraestrutura de comunicação.
Monitoramento de PostgreSQL em ambientes de alta disponibilidade
Um cluster PostgreSQL não deve ser considerado altamente disponível apenas porque possui múltiplos servidores.
É necessário monitorar continuamente o estado dos componentes.
Entre os indicadores importantes estão:
- Status do Primary
- Status dos Standbys
- Atraso de replicação
- WAL gerado
- WAL recebido
- WAL aplicado
- Conexões
- CPU
- Memória
- Armazenamento
- Latência de disco
- Latência de rede
- Espaço disponível
- Erros do PostgreSQL
- Eventos de failover
O monitoramento deve produzir alertas antes que uma condição de degradação provoque indisponibilidade.
Quorum e controle de decisões no cluster
Ambientes de alta disponibilidade precisam determinar como decisões críticas serão tomadas quando existe falha de comunicação entre os componentes.
O conceito de quorum é importante porque ajuda a evitar que uma falha de comunicação seja interpretada incorretamente como falha de servidor.
Dependendo da arquitetura, componentes adicionais podem participar do processo de decisão e garantir que apenas um servidor seja promovido a Primary.
Esse desenho deve ser cuidadosamente planejado para evitar situações de split-brain.
Alta disponibilidade PostgreSQL em ambientes virtualizados
PostgreSQL Enterprise pode ser implementado em ambientes físicos, virtuais ou plataformas de infraestrutura em nuvem.
Em ambientes virtualizados, entretanto, é necessário analisar se os servidores que compõem o cluster realmente estão independentes.
Colocar dois nós do cluster no mesmo host físico, no mesmo domínio de falha ou sobre o mesmo componente crítico pode reduzir significativamente a proteção oferecida pela arquitetura.
O planejamento deve considerar:
- Hosts físicos
- Clusters de virtualização
- Domínios de falha
- Armazenamento
- Rede
- Energia
- Localização física
- Dependências compartilhadas
Alta disponibilidade PostgreSQL em ambientes de nuvem
Ambientes de nuvem oferecem recursos que podem facilitar a construção de arquiteturas resilientes, mas a simples utilização de uma plataforma de nuvem não garante alta disponibilidade.
É necessário analisar regiões, zonas de disponibilidade, redes, armazenamento, conectividade e mecanismos de recuperação.
Um projeto PostgreSQL Enterprise deve identificar claramente quais componentes continuam funcionando caso uma zona ou recurso de infraestrutura fique indisponível.
Como dimensionar uma arquitetura PostgreSQL Enterprise Alta Disponibilidade
O dimensionamento deve começar pelos requisitos da aplicação.
Antes de definir a quantidade de servidores, é necessário entender:
- Volume de dados
- Taxa de crescimento
- Volume de transações
- Quantidade de conexões
- Perfil de leitura e escrita
- RPO
- RTO
- Janela de manutenção
- Necessidade de Disaster Recovery
- Localização dos usuários
- Requisitos de segurança
Somente depois dessas informações deve ser definida a arquitetura física ou virtual.
Estratégias para reduzir pontos únicos de falha
Uma arquitetura PostgreSQL Enterprise pode continuar vulnerável mesmo com múltiplos servidores caso outros componentes permaneçam como pontos únicos de falha.
É necessário avaliar:
- Servidor
- Armazenamento
- Rede
- Switches
- Balanceadores
- DNS
- Energia
- Site físico
- Camada de virtualização
- Serviços externos necessários para a operação
O objetivo é evitar que a falha de um único componente crítico provoque a indisponibilidade completa do banco de dados.
Testes de failover PostgreSQL
Uma arquitetura de alta disponibilidade precisa ser testada regularmente.
Não é suficiente verificar se a replicação está funcionando. É necessário validar o comportamento completo da infraestrutura durante uma falha.
Os testes podem envolver:
- Falha do Primary
- Falha de rede
- Falha do armazenamento
- Perda de conectividade
- Promoção de Standby
- Redirecionamento das aplicações
- Recuperação do servidor antigo
- Reintegração ao cluster
- Validação dos dados
Os procedimentos de failover devem ser documentados e conhecidos pelas equipes responsáveis pela operação.
Alta disponibilidade e manutenção planejada
Um dos benefícios de uma arquitetura redundante é a possibilidade de realizar determinadas atividades de manutenção com menor impacto sobre a disponibilidade.
Dependendo da arquitetura, operações como atualização de infraestrutura, manutenção de determinados componentes e intervenções planejadas podem ser executadas de maneira controlada utilizando réplicas.
Entretanto, cada procedimento deve ser validado de acordo com a versão do PostgreSQL, arquitetura de replicação, ferramenta de gerenciamento e características da aplicação.
PostgreSQL Enterprise Alta Disponibilidade e segurança
Alta disponibilidade também precisa considerar segurança.
Os canais de replicação devem ser protegidos adequadamente e os acessos administrativos devem seguir políticas de controle de privilégios.
Também é importante proteger:
- Credenciais
- Conexões entre servidores
- Servidores de administração
- Backups
- Arquivos de configuração
- Logs
- Interfaces de gerenciamento
Uma arquitetura altamente disponível mas vulnerável a comprometimento de segurança não atende aos requisitos completos de continuidade operacional.
PostgreSQL Enterprise Alta Disponibilidade versus PostgreSQL isolado
Um servidor PostgreSQL isolado pode atender aplicações de menor criticidade e ambientes nos quais uma indisponibilidade temporária seja aceitável.
Em ambientes corporativos críticos, entretanto, a dependência de um único servidor aumenta o risco operacional.
A arquitetura de alta disponibilidade adiciona componentes e complexidade, mas também reduz a dependência de um único ponto de execução.
A decisão deve considerar o impacto financeiro e operacional de uma interrupção.
Quando implementar PostgreSQL Enterprise Alta Disponibilidade
A alta disponibilidade tende a ser especialmente importante quando o PostgreSQL suporta sistemas cuja indisponibilidade produz impacto significativo para a organização.
Alguns exemplos incluem:
- Sistemas transacionais críticos
- ERP
- Sistemas financeiros
- Plataformas digitais
- Sistemas de atendimento
- Aplicações corporativas
- Portais de clientes
- Plataformas de comércio eletrônico
- Sistemas de integração
- Aplicações que operam continuamente
Boas práticas para PostgreSQL Enterprise Alta Disponibilidade
- Definir RPO e RTO antes da arquitetura
- Implementar replicação adequada ao requisito
- Monitorar continuamente o cluster
- Evitar pontos únicos de falha
- Planejar o failover
- Evitar cenários de split-brain
- Manter backups independentes das réplicas
- Testar procedimentos de recuperação
- Documentar procedimentos operacionais
- Manter versões e componentes suportados
- Monitorar atraso de replicação
- Validar o comportamento das aplicações durante failover
- Planejar Disaster Recovery
- Revisar periodicamente a capacidade do ambiente
PostgreSQL Enterprise Alta Disponibilidade em projetos de migração Oracle
Para organizações que estão migrando Oracle para PostgreSQL, a alta disponibilidade deve fazer parte do projeto desde a fase de arquitetura.
Não é recomendável migrar inicialmente para um ambiente isolado e somente depois definir como a plataforma deverá atender requisitos de disponibilidade.
Durante o planejamento da migração devem ser avaliados:
- Arquitetura atual do Oracle
- Requisitos de disponibilidade
- RPO
- RTO
- Volume de dados
- Perfil das aplicações
- Dependências externas
- Estratégia de replicação
- Estratégia de backup
- Disaster Recovery
- Monitoramento
- Procedimentos de failover
Esse planejamento permite que a nova plataforma PostgreSQL seja desenhada de acordo com os requisitos reais do ambiente corporativo.
Arquitetura PostgreSQL Enterprise Alta Disponibilidade: principais componentes
| Componente | Função |
|---|---|
| Primary | Servidor responsável pelas operações principais do banco |
| Standby | Servidor que mantém uma cópia dos dados para recuperação |
| Replicação | Transporte das alterações entre os servidores |
| Failover | Processo de transferência do serviço para outro servidor |
| Monitoramento | Identificação de falhas e degradações |
| Backup | Proteção contra perda ou corrupção lógica dos dados |
| Disaster Recovery | Recuperação diante de incidentes de maior impacto |
| Camada de acesso | Direcionamento das conexões das aplicações |
FAQ — Perguntas Frequentes
O que é PostgreSQL Enterprise Alta Disponibilidade?
É uma arquitetura formada por PostgreSQL e componentes de infraestrutura, replicação, monitoramento e failover destinada a reduzir o tempo de indisponibilidade do banco de dados diante de falhas.
PostgreSQL possui alta disponibilidade nativa?
O PostgreSQL fornece mecanismos fundamentais para construção de arquiteturas de alta disponibilidade, como replicação e recursos de recuperação. A automação completa de failover e o gerenciamento do ambiente podem exigir componentes e ferramentas adicionais.
Qual a diferença entre replicação e alta disponibilidade?
Replicação mantém cópias dos dados em outros servidores. Alta disponibilidade utiliza replicação em conjunto com mecanismos de detecção, failover, acesso e recuperação para manter o serviço operacional diante de falhas.
Alta disponibilidade substitui backup?
Não. Réplicas não devem ser consideradas substitutas de backup. Um backup independente continua sendo necessário para recuperação contra erros operacionais, exclusões acidentais, corrupção lógica e outros incidentes.
O que é failover PostgreSQL?
É o processo de transferência da função principal do banco para outro servidor, normalmente uma réplica, após uma falha ou indisponibilidade do servidor Primary.
O que são RPO e RTO?
RPO define a quantidade máxima de dados que pode ser perdida em um incidente. RTO define o tempo máximo aceitável para recuperação do serviço.
É possível utilizar PostgreSQL Enterprise em ambientes de missão crítica?
Sim. O PostgreSQL pode ser utilizado em arquiteturas corporativas e de missão crítica quando adequadamente dimensionado, configurado, monitorado e integrado a mecanismos de alta disponibilidade, backup e Disaster Recovery.
O EDB Failover Manager pode ser utilizado em alta disponibilidade PostgreSQL?
Sim. O EDB Failover Manager é uma das tecnologias disponíveis no ecossistema EnterpriseDB para gerenciamento de failover em ambientes PostgreSQL.
Alta disponibilidade exige dois servidores PostgreSQL?
Uma arquitetura básica pode utilizar um Primary e um Standby. Ambientes mais críticos podem utilizar múltiplas réplicas e componentes adicionais para aumentar a resiliência.
Como testar uma arquitetura PostgreSQL de alta disponibilidade?
É necessário executar testes controlados de falha do Primary, promoção de Standby, redirecionamento das aplicações, validação dos dados e recuperação do servidor afetado.
Links Relacionados
- Alta Disponibilidade PostgreSQL
- Cluster PostgreSQL
- Replicação PostgreSQL
- Failover PostgreSQL
- Disaster Recovery PostgreSQL
- Backup PostgreSQL
- PostgreSQL para Missão Crítica
- PostgreSQL Corporativo
Recursos Oficiais
- PostgreSQL — High Availability, Load Balancing, and Replication
- PostgreSQL — Log-Shipping Standby Servers
- PostgreSQL — Failover
- EDB Failover Manager — Documentação Oficial
- EDB Failover Manager — Quick Start
Modernize seu Banco de Dados com a Dominus Tech
👉 Planejando uma Migração Oracle para PostgreSQL?
A Dominus Tech é Parceira Gold da EnterpriseDB e apoia empresas em todas as etapas da modernização de bancos de dados Oracle para PostgreSQL. Nossa equipe atua em assessment, planejamento, análise de compatibilidade, arquitetura, migração, otimização de desempenho, alta disponibilidade, observabilidade e suporte especializado para ambientes PostgreSQL Enterprise.
✔ Parceira Gold da EnterpriseDB no Brasil
O planejamento adequado permite transformar uma migração complexa em um projeto estruturado, com riscos identificados, responsabilidades definidas, critérios de sucesso e estratégia de execução. A Dominus Tech pode apoiar sua organização desde a avaliação inicial até a estabilização do ambiente PostgreSQL em produção.